
Databricks Certified Data Engineer Associate Exam (Databricks-Certified-Data-Engineer-Associate日本語版) - Databricks-Certified-Data-Engineer-Associate日本語무료 덤프문제 풀어보기
データエンジニアリングチームは、顧客取引を、customer_id、amount、categoryという列を持つtransactionsという名前のPySparkデータフレームを使用して分析しています。
チームは、効率化のため、顧客ごとに取引総額、平均取引額、最大取引額をすべて1回の操作で計算する必要がある。
PySparkでこれを実現するには、どのコード断片を使用すればよいでしょうか?
チームは、効率化のため、顧客ごとに取引総額、平均取引額、最大取引額をすべて1回の操作で計算する必要がある。
PySparkでこれを実現するには、どのコード断片を使用すればよいでしょうか?
정답: D
설명: (Fast2test 회원만 볼 수 있음)
Databricksのシングルタスクワークフローは、ノートブックのエラーにより最後のタスクで失敗しました。データエンジニアはノートブックのエラーを修正しました。ワークフローを再実行するにはどうすればよいでしょうか?
정답: C
설명: (Fast2test 회원만 볼 수 있음)
データエンジニアが、Kafkaからのクリックストリームイベントとクラウドオブジェクトストレージからの日次製品カタログを取り込む新しいDatabricksパイプラインを構築しています。監査可能性と容易な再処理を確保するため、エンジニアはすべてのソースデータを取り込みたいと考えています。後の段階では、データがダッシュボードで使用される前に、データのクリーニング、重複排除、およびビジネスモデリングが行われます。
どちらのアプローチがメダリオンアーキテクチャの原則に合致していますか?
どちらのアプローチがメダリオンアーキテクチャの原則に合致していますか?
정답: A
설명: (Fast2test 회원만 볼 수 있음)
データエンジニアがSpark SQLに基づいたETLプロセスを開発している。実行が失敗する。データエンジニアがSpark UIを確認すると、次のようなエラーが表示されている。
「java.lang.OutofMemoryError: Javaヒープ領域不足」
この問題を解決するために、データエンジニアはどの2つの是正措置を実行すべきでしょうか?(2つ選択してください。)
「java.lang.OutofMemoryError: Javaヒープ領域不足」
この問題を解決するために、データエンジニアはどの2つの是正措置を実行すべきでしょうか?(2つ選択してください。)
정답: C,E
설명: (Fast2test 회원만 볼 수 있음)
Databricksでデータエンジニアとして働く人は、販売分析領域におけるBIクエリのレイテンシとコストを制御する必要があります。Silverテーブルには、検証済みで正規化された販売データと製品データが既に含まれています。チームは、ダッシュボードに適したクエリパフォーマンスを実現し、複雑な結合処理でアナリストに負担をかけることなく、データセットをビジネスコンセプト(例:weekly_sales、account_performance)に整合させたいと考えています。
データエンジニアは、メダリオンアーキテクチャのゴールドレイヤーに対して、どの設計アプローチを選択すべきでしょうか?
データエンジニアは、メダリオンアーキテクチャのゴールドレイヤーに対して、どの設計アプローチを選択すべきでしょうか?
정답: C
설명: (Fast2test 회원만 볼 수 있음)
データエンジニアは、SQLクエリで使用したいPython変数table_nameを持っています。table_nameを使用してクエリを実行するPythonコードブロックを作成したいと考えています。
次のような不完全なコード ブロックがあります。
____(f"SELECT customer_id, spending FROM {table_name}")
空欄を埋めてタスクを正常に完了するには、次のうちどれを使用できますか?
次のような不完全なコード ブロックがあります。
____(f"SELECT customer_id, spending FROM {table_name}")
空欄を埋めてタスクを正常に完了するには、次のうちどれを使用できますか?
정답: A
サーバーレスコンピューティングクラスターでサポートされている言語はどれですか?(2つ選択してください。)
정답: A,E
설명: (Fast2test 회원만 볼 수 있음)
データ エンジニアは、データ パイプラインの一部として Delta テーブルを使用する必要がありますが、適切な権限があるかどうかがわかりません。
データ エンジニアがテーブルに対する権限を確認できるのは次のどの場所ですか。
データ エンジニアがテーブルに対する権限を確認できるのは次のどの場所ですか。
정답: E
Lakeflow Jobsワークフローが、ノートブックタスクのエラーにより最後のタスクで失敗しました。このワークフローは毎日実行されるようにスケジュールされています。データエンジニアはノートブックを修正し、パイプラインを再実行したいと考えています。このワークフローは計算負荷が高く、実行コストも高額です。データエンジニアは、ダウンタイムと計算コストを最小限に抑えるために、どのような対策を講じるべきでしょうか?
정답: D
설명: (Fast2test 회원만 볼 수 있음)
データエンジニアは、ダッシュボードをデプロイする宣言型自動化バンドル(旧称:Databricksアセットバンドル)を管理します。
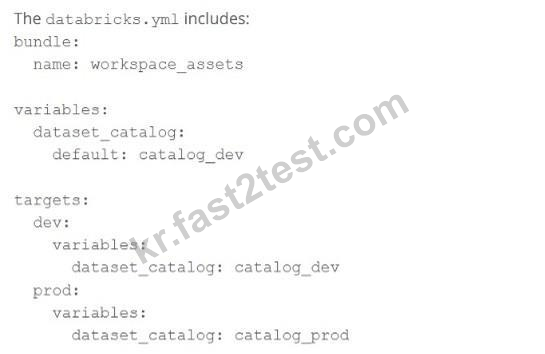
リソース定義を変更せずに、catalog_prodを使用してダッシュボードを本番環境にデプロイできるようにするには、どの操作を行う必要がありますか?
リソース定義を変更せずに、catalog_prodを使用してダッシュボードを本番環境にデプロイできるようにするには、どの操作を行う必要がありますか?
정답: D
설명: (Fast2test 회원만 볼 수 있음)
データエンジニアが、eコマース取引のデルタテーブルにおいてパフォーマンス上のボトルネックに直面している。
このテーブルは管理対象のUnityカタログテーブルであり、データレイアウト方式でパーティショニングとZオーダーを使用しています。また、Unityカタログテーブルの予測最適化も有効になっています。このテーブルには頻繁に変更されるクエリフィルタがあり、データエンジニアはデータレイアウトや予測最適化によるメリットを実感できていません。データエンジニアはデータレイアウトのボトルネックをどのように解消すべきでしょうか?
このテーブルは管理対象のUnityカタログテーブルであり、データレイアウト方式でパーティショニングとZオーダーを使用しています。また、Unityカタログテーブルの予測最適化も有効になっています。このテーブルには頻繁に変更されるクエリフィルタがあり、データエンジニアはデータレイアウトや予測最適化によるメリットを実感できていません。データエンジニアはデータレイアウトのボトルネックをどのように解消すべきでしょうか?
정답: C
설명: (Fast2test 회원만 볼 수 있음)
ある企業は、複数のカテゴリー(例:電子機器、衣料品)と地域にわたって製品を販売している。
営業チームは、以下のような sales_df という名前の PySpark データフレームを提供しました。チームは、データエンジニアにこの販売データを分析してもらい、戦略的な意思決定に役立ててもらいたいと考えています。
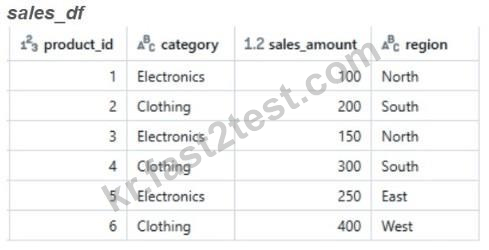
各地域ごとの総売上高を計算し、その結果をregion_salesという名前の新しいデータフレームに格納します。
予想される結果:
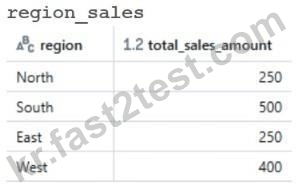
どのコードが期待通りの結果を生成しますか?
営業チームは、以下のような sales_df という名前の PySpark データフレームを提供しました。チームは、データエンジニアにこの販売データを分析してもらい、戦略的な意思決定に役立ててもらいたいと考えています。
各地域ごとの総売上高を計算し、その結果をregion_salesという名前の新しいデータフレームに格納します。
予想される結果:
どのコードが期待通りの結果を生成しますか?
정답: A
설명: (Fast2test 회원만 볼 수 있음)
次のコマンドのうち、データベース customer360 の場所を返すものはどれですか?
정답: D
データエンジニアは、共有クラスタを使用して、営業チームが作成したビューにアクセスする必要があります。データエンジニアには、カタログとスキーマの使用権限が付与されています。営業チームが作成したビューにアクセスするために、データエンジニアは他にどのような最小限の権限が必要ですか?
정답: A
データエンジニアは、Databricksを使用してKafkaからDelta Lakeテーブルにストリーミングデータを取り込む必要があります。パイプラインは、厳密に1回限りの処理セマンティクスを保証し、障害から復旧するためのチェックポイント情報を維持する必要があります。信頼性の高い処理と耐障害性を保証するSpark Structured Streamingの機能はどれですか?
정답: D